
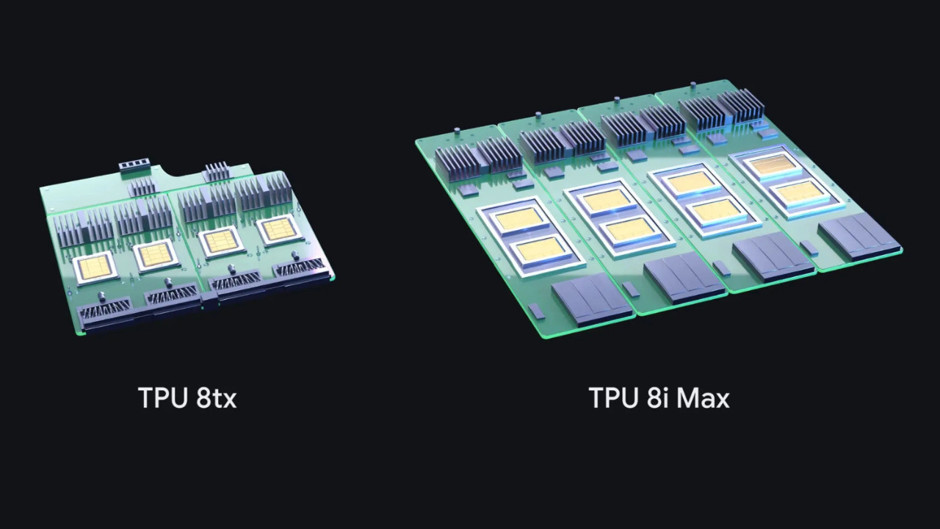
Google, yapay zeka altyapısını iki yeni TPU sistemiyle genişletti. TPU 8tx, hassas verilerle çalışan yapay zeka modellerinin güvenliğine odaklanırken TPU 8i Max, büyük miktarda bilgiyi aynı anda işleyen modeller için daha fazla hesaplama gücü ve bellek bant genişliği sunuyor. Şirket, 9 Kasım'da duyurduğu bu sistemlerle sekizinci nesil TPU ailesindeki seçenek sayısını dörde çıkardı.
TPU (Tensor Processing Unit), Google'ın yapay zeka hesaplamalarını hızlandırmak için geliştirdiği özel işlemci ailesi. Yeni duyurunun önemli ayrıntısı ise TPU 8tx ve 8i Max'in baştan tasarlanmış iki ayrı çip olmaması. Google, nisan ayında tanıttığı TPU 8t ve 8i işlemcilerini farklı donanım yapılandırmalarıyla yeni kullanım alanlarına uyarladı.
TPU 8tx: Hassas veriler işlenirken de korunacak
Finans kuruluşları, kamu kurumları ve büyük şirketler için yapay zeka kullanmanın önemli sorunlarından biri veri güvenliği. Belgeler depolanırken veya ağ üzerinden aktarılırken şifrelenebiliyor. Ancak geleneksel sistemlerde işlem yapılabilmesi için verilerin bellekte çözümlenmesi gerekiyor.
TPU 8tx bu aşamadaki güvenlik risklerini azaltmak üzere geliştirildi. TPU 8t ile aynı işlemciyi kullanan sistem, beşinci nesil AMD EPYC sunucu işlemcileriyle birlikte çalışıyor. Google'ın açıklamasına göre donanım düzeyindeki güvenlik özellikleri, hassas verilerin ve yapay zeka modellerine ait ağırlıkların işlem sırasında da korunmasını ve yalıtılmasını hedefliyor.
Şirket, bu sistemde düşük gecikme için geliştirdiği Boardfly ağ mimarisinden de yararlanıyor. Google'ın verdiği değerlere göre TPU 8tx, TPU 8t'ye kıyasla iki kata kadar daha düşük iletişim gecikmesi sunabiliyor.
TPU 8tx yalnızca hazır modelleri çalıştırmak için tasarlanmadı. Şirketler aynı altyapı üzerinde kendi verileriyle model ince ayarı yapabilecek, büyük modellerden daha küçük modeller türetebilecek ve pekiştirmeli öğrenme çalışmaları yürütebilecek. Böylece hassas verilerin farklı işlem kümeleri arasında taşınması ihtiyacı da azalacak.
TPU 8i Max: İki çip tek pakette birleşiyor
TPU 8i Max ise özellikle çok geniş bağlam pencerelerine sahip yapay zeka modelleri için geliştirildi. Bağlam penceresi, bir modelin tek işlem sırasında değerlendirebildiği metin, kod ve diğer bilgilerin miktarını ifade ediyor.
Örneğin bir yazılım geliştirme ajanı, büyük bir projenin dosyalarını birlikte incelemek veya uzun süreli işlemler boyunca önceki adımları hatırlamak zorunda kalabilir. Bu tür görevlerde işlem gücü kadar verilere hızlı erişebilmek de belirleyici hale geliyor.
Google, bu ihtiyacı karşılamak için iki TPU 8i çipini tek bir pakette birleştirdi. Şirketin açıkladığı teknik özelliklere göre TPU 8i Max, standart TPU 8i'ye kıyasla iki kat hesaplama gücü, iki kat çip üzeri SRAM ve iki kat yüksek bant genişlikli bellek (HBM) bant genişliği sunuyor.
SRAM, işlemcinin sık ihtiyaç duyduğu verilere hızlı erişmesini sağlarken HBM bant genişliği, büyük miktarda verinin işlem birimlerine ne kadar hızlı taşınabileceğini belirliyor. Bu kaynakların artırılması, özellikle uzun bağlamlı işlemlerde işlemcilerin veri bekleyerek zaman kaybetmesini azaltmayı amaçlıyor.
Yeni tasarım ayrıca mevcut sunucu rafı alanına iki kat daha fazla çip yerleştirilmesini sağlıyor. Böylece veri merkezleri fiziksel alanı genişletmeden hesaplama yoğunluğunu artırabiliyor.
Google, TPU yazılım desteğini de genişletiyor
Google'ın yenilikleri donanımla sınırlı değil. Şirket, ekim ayında açık kaynak haline getirdiği TorchTPU ile PyTorch kullanan geliştiricilerin mevcut yapay zeka modellerini TPU sistemlerine taşımasını kolaylaştırdı.
Bu gelişme önemli çünkü PyTorch, yapay zeka modellerinin geliştirilmesinde yaygın kullanılan yazılım altyapılarından biri. Google, Hugging Face modellerinin de TorchTPU üzerinden çalıştırılmasını destekleyerek TPU kullanımının önündeki yazılım engellerini azaltmaya çalışıyor.
Yeni duyuruyla birlikte TPU Agent Suite adlı araç paketi de ön izleme aşamasında kullanıma sunuldu. Claude Code, Cursor ve Google Antigravity gibi geliştirme araçlarıyla çalışan sistem, TPU'ya geçişte karşılaşılan sorunları tespit etmek ve donanıma özel yazılım optimizasyonlarını otomatikleştirmek için tasarlandı.
Şirket ayrıca TPU Sync adlı açık kaynak bellek yönetim sistemini duyurdu. Google Kubernetes Engine üzerindeki Cloud Pathways ve dinamik dilimleme özellikleri de genel kullanıma açıldı. Bu araçlar, büyük TPU kümelerinin daha esnek yönetilmesini ve hesaplama kaynaklarının farklı iş yükleri arasında dağıtılmasını hedefliyor.
Nvidia ile rekabette ne değişecek?
Google'ın resmi duyurusunda öne çıkan yaklaşım, her yapay zeka görevi için tek tip donanım kullanmak yerine farklı ihtiyaçlara göre özelleştirilmiş sistemler oluşturmak.
Sekizinci nesil ailede TPU 8t büyük modellerin eğitimine, TPU 8i düşük gecikmeli yapay zeka işlemlerine, TPU 8tx güvenli veri işlemeye ve TPU 8i Max geniş bağlamlı görevlere odaklanıyor.
Bu çeşitlilik, Google'ın Nvidia'nın GPU tabanlı yapay zeka altyapılarına alternatif oluşturma çabasının bir parçası. Özellikle PyTorch desteğinin genişlemesi, geliştiricilerin farklı donanım platformları arasında geçiş yapmasını kolaylaştırabilecek önemli bir adım.
Buna karşılık Google, TPU 8i Max'in fiyatını, güç tüketimini ve bu sisteme özgü ayrıntılı uygulama performansı sonuçlarını henüz açıklamadı. Dolayısıyla Nvidia'nın Rubin platformuyla maliyet ve enerji verimliliği açısından doğrudan karşılaştırma yapmak için yeterli veri bulunmuyor.
Yeni TPU sistemlerinin müşterilere hangi tarihte ve hangi fiyatlarla sunulacağı da açıklığa kavuşmuş değil.